Debezium to stream data from Oracle to MariaDB
Table of contents
Preamble
Debezium is an open source distributed platform for change data capture. Debezium can be installed as a standalone server or through a connector in Kafka Connect. Kafka Connect is a tool for scalability and reliably streaming data between Apache Kafka and other systems.
The list of source connector is already quite complete:
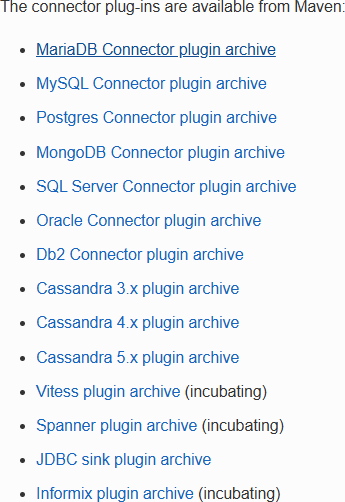
While the sink connector is relying on JDBC. So if your target database is proposing a JDBC plugin then you can use it as a target. The list obviously include Oracle, MariaDB, MySQL, PostgreSQL, SQL Server and Db2.
If you use Kafka from Apache and this open source, free, Debezium connector you can build a free solution to replicate from one database flavor to another database flavor. And obviously if you go via Kafka Connect from a database flavor to Kafka, you can send those events to any system with Kafka.
I would say for a simple use case it does the job but the “one table – one topic” approach would kill the use case in a complex system with thousands of tables. I have not tested it bu apparently using topic routing or a dedicated topic naming strategy you can void it but it is more complex and it will be harder for consumer to extract information from messages… For Oracle, User Defined Types (UDF) are not handled. The primary key for each table can also be a constraint, of course it is highly recommended but GoldenGate is able to work without a primary key. I would recommend GoldenGate for Oracle and GoldenGate for non-Oracle in case of a more complex environment as GoldenGate is really much simpler to implement. GoldenGate for Distributed Applications and Analytics (DAA), to replicate to Kafka (or else) is really more expensive and difficult to be recommended…
In have used Oracle Enterprise Edition 21.18, in fact a pluggable database as source database. MariaDB 11.8.2 Community Edition as destination database. Debezium version is 3.1.3. Apache Kafka release is 4.0.0.
My server is running all this with 12 cores, 64GB of memory and Red Hat Enterprise Linux release 8.10 (Ootpa).
Apache Kafka installation
For this trial I have decided to use the open source version of Apache Kafka. Java 17 required:
[kafka@server01 ~]$ java -version
openjdk version "17.0.15" 2025-04-15 LTS
OpenJDK Runtime Environment (Red_Hat-17.0.15.0.6-1) (build 17.0.15+6-LTS)
OpenJDK 64-Bit Server VM (Red_Hat-17.0.15.0.6-1) (build 17.0.15+6-LTS, mixed mode, sharing)
I have unzip Kafka 4.0.0 in the home of my kafka Linux account so adding this to profile:
[kafka@server01 ~]$ tail -n 2 .bash_profile
export KAFKA_HOME=~/kafka_2.13-4.0.0
export PATH=$PATH:$KAFKA_HOME/bin
Generate a Cluster UUID (and add it to your profile):
[kafka@server01 ~]$ KAFKA_CLUSTER_ID="$(kafka-storage.sh random-uuid)"
[kafka@server01 ~]$ echo $KAFKA_CLUSTER_ID
BNHVoCj-TwadYTFG_ukFow
[kafka@server01 ~]$ echo "export KAFKA_CLUSTER_ID=BNHVoCj-TwadYTFG_ukFow" >> .bash_profile
Format Log Directories:
[kafka@server01 ~]$ kafka-storage.sh format --standalone -t $KAFKA_CLUSTER_ID -c $KAFKA_HOME/config/server.properties
Formatting dynamic metadata voter directory /tmp/kraft-combined-logs with metadata.version 4.0-IV3.
I have slightly modified the configuration file to put the FQDN of my server:
process.roles=broker,controller
node.id=1
controller.quorum.bootstrap.servers=server01.domain.com:9093
listeners=BROKER://:9092,CONTROLLER://:9093
inter.broker.listener.name=BROKER
advertised.listeners=BROKER://server01.domain.com:9092,CONTROLLER://server01.domain.com:9093
controller.listener.names=CONTROLLER
listener.security.protocol.map=BROKER:PLAINTEXT,CONTROLLER:PLAINTEXT
Start Kafka server:
nohup kafka-server-start.sh $KAFKA_HOME/config/server.properties > ~/kafka-server-start.log 2>&1 &
Remark:
If having something like:
[2025-07-01 16:07:46,108] INFO [MetadataLoader id=1] initializeNewPublishers: the loader is still catching up because we still don't know the high water mark yet. (org.apache.kafka.image.loader.MetadataLoader)
Purge the previous trial (Confluent Kafka for me) with:
[kafka@server01 ~]$ rm -rf /tmp/kraft-combined-logs
For testing I create an oracle-kafka topic with:
[kafka@server01 ~]$ kafka-topics.sh --create --topic oracle-kafka --bootstrap-server localhost:9092
Created topic oracle-kafka.
[kafka@server01 ~]$ kafka-topics.sh --describe --topic oracle-kafka --bootstrap-server localhost:9092
Topic: oracle-kafka     TopicId: XFaCWT9oRh2pPsUZti4Dgw PartitionCount: 1       ReplicationFactor: 1    Configs: segment.bytes=1073741824
        Topic: oracle-kafka     Partition: 0    Leader: 1       Replicas: 1     Isr: 1  Elr:    LastKnownElr:
[kafka@server01 ~]$ kafka-topics.sh --list --bootstrap-server localhost:9092
__consumer_offsets
oracle-kafka
The produce and consume message with:
[kafka@server01 ~]$ kafka-console-producer.sh --topic oracle-kafka --bootstrap-server localhost:9092 --property parse.key=true --property key.separator=,
>One,My first message
>^C
[kafka@server01 ~]$ kafka-console-consumer.sh --topic oracle-kafka --from-beginning --bootstrap-server localhost:9092
My first message
^CProcessed a total of 1 messages
To clean this new topic use:
[kafka@server01 ~]$ kafka-topics.sh --topic oracle-kafka --delete --bootstrap-server localhost:9092
Apache Kafka Connect configuration
I have downloaded MariaDB Connector plugin archive (not required for now, but planning further testing) and Oracle Connector plugin archive from download page and put them in ~/connectors directory.
Uncompressed both of them to have a directory like:
[kafka@server01 ~]$ ll ~/connectors
total 49644
drwxr-x--- 2 kafka users     4096 Jul  1 17:44 debezium-connector-mariadb
-rw-r----- 1 kafka users 13453614 Jul  1 15:43 debezium-connector-mariadb-3.1.3.Final-plugin.tar.gz
drwxr-x--- 2 kafka users     8192 Jul  1 17:44 debezium-connector-oracle
-rw-r----- 1 kafka users 37363473 Jul  1 15:43 debezium-connector-oracle-3.1.3.Final-plugin.tar.gz
Then in $KAFKA_HOME/config/connect-standalone.properties I have added this line (specify the upper directory where you have unzip all your connectors):
plugin.path=/home/kafka/connectors
Execute Kafka Connect with something like:
[kafka@server01 ~]$ nohup connect-standalone.sh $KAFKA_HOME/config/connect-standalone.properties 1> ~/connect-standalone.log 2>&1 &
In the log you should see:
[2025-07-01 17:44:28,968] WARN One or more plugins are missing ServiceLoader manifests may not be usable with plugin.discovery=service_load: [
file:/home/kafka/connectors/debezium-connector-mariadb/ io.debezium.transforms.VectorToJsonConverter    transformation  3.1.3.Final
file:/home/kafka/connectors/debezium-connector-oracle/  io.debezium.transforms.VectorToJsonConverter    transformation  3.1.3.Final
]
Read the documentation at https://kafka.apache.org/documentation.html#connect_plugindiscovery for instructions on migrating your plugins to take advantage of the performance improvements of service_load mode.
To silence this warning, set plugin.discovery=only_scan in the worker config. (org.apache.kafka.connect.runtime.isolation.Plugins:123)
Debezium Connector for Oracle configuration
I have downloaded latest ojdbc17.jar from Oracle Database JDBC driver and Companion Jars Downloads and latest 23.8 XDB library (xdb-23.8.0.25.04.jar) for Oracle and put both jar files in /home/kafka/connectors/debezium-connector-oracle
On my CDB database I create the c##dbzuser global user with:
create user c##dbzuser identified by dbz
default tablespace users
quota unlimited on users
temporary tablespace temp
container=all;

grant create session to c##dbzuser container=all;
grant set container to c##dbzuser container=all;
grant select on v_$database to c##dbzuser container=all;
grant flashback any table to c##dbzuser container=all;
grant select any table to c##dbzuser container=all;
grant select_catalog_role to c##dbzuser container=all;
grant execute_catalog_role to c##dbzuser container=all;
grant select any transaction to c##dbzuser container=all;
grant logmining to c##dbzuser container=all;

grant create table to c##dbzuser container=all;
grant lock any table to c##dbzuser container=all;
grant create sequence to c##dbzuser container=all;

grant execute on dbms_logmnr to c##dbzuser container=all;
grant execute on dbms_logmnr_d to c##dbzuser container=all;

grant select on v_$log to c##dbzuser container=all;
grant select on v_$log_history to c##dbzuser container=all;
grant select on v_$logmnr_logs to c##dbzuser container=all;
grant select on v_$logmnr_contents to c##dbzuser container=all;
grant select on v_$logmnr_parameters to c##dbzuser container=all;
grant select on v_$logfile to c##dbzuser container=all;
grant select on v_$archived_log to c##dbzuser container=all;
grant select on v_$archive_dest_status to c##dbzuser container=all;
grant select on v_$transaction to c##dbzuser container=all;

grant select on v_$mystat to c##dbzuser container=all;
grant select on v_$statname to c##dbzuser container=all;
On my PDB1 pluggable database:
SQL> create user app01 identified by "secure_password"
     default tablespace users
     quota unlimited on users
     temporary tablespace temp;

User APP01 created.

SQL> grant connect, resource to app01;

Grant succeeded.
As app01 user on PDB1 pluggable database:
SQL> drop table app01.employees purge;

Table dropped.

SQL> create table app01.employees (
  id number(6) not null,
  name varchar2(50),
  constraint employees_pk primary key (id) enable
);

Table created.

SQL> alter table app01.employees add supplemental log data (primary key) columns;

Table altered.
Remark:
I have tried not to define a primary key on my table and firing:
SQL> alter table app01.employees add supplemental log data (all) columns;

Table altered.
But it has some serious limitation, as you cannot specify “primary.key.mode”: “record_key” and so not being able to use “delete.enabled”: “true” so DELETE will not be propagated…
Then I have the Oracle Debezium configuration to replicate all objects of app01 schema:
{
  "name": "server01_orcl1_pdb1_app01",
  "config": {
    "connector.class" : "io.debezium.connector.oracle.OracleConnector",
    "database.hostname" : "server01.domain.com",
    "database.port" : "1531",
    "database.user" : "c##dbzuser",
    "database.password" : "dbz",
    "database.dbname" : "orcl1",
    "topic.prefix" : "server01_orcl1_pdb1",
    "tasks.max" : "1",
    "database.pdb.name" : "pdb1",
    "schema.include.list" : "app01",
    "snapshot.mode" : "no_data",
    "schema.history.internal.store.only.captured.tables.ddl": "true",
    "schema.history.internal.kafka.bootstrap.servers" : "server01.domain.com:9092",
    "schema.history.internal.kafka.topic": "schema-changes.inventory.app01"
  }
}
Remark:
In the above configuration: “snapshot.mode” : “no_data”, to have the snapshot includes only the structure of captured tables. Specify this value if you want the connector to capture data only for changes that occur after the snapshot.
Insert a row in app01.employees:
SQL> insert into employees values(1, 'Yannick Jaquier');

1 row created.

SQL> commit;

Commit complete.
Once done the list of topic updated (server01_orcl1_pdb1.APP01.EMPLOYEES created only once you have inserted one row). Each time you add a new table a new topic called server01_orcl1_pdb1.APP01.{table_name} is created:
[kafka@server01 ~]$ kafka-topics.sh --list --bootstrap-server localhost:9092
__consumer_offsets
server01_orcl1_pdb1
server01_orcl1_pdb1.APP01.EMPLOYEES
schema-changes.inventory.app01
The inserted row, not really human readable but we can see my name in this below message:
[kafka@server01 ~]$ kafka-console-consumer.sh --topic server01_orcl1_pdb1.APP01.EMPLOYEES --from-beginning --bootstrap-server localhost:9092
{"schema":{"type":"struct","fields":[{"type":"struct","fields":[{"type":"int32","optional":false,"field":"ID"},{"type":"string","optional":true,"field":"NAME"}],"optional":true,"name":"server01_orcl1_pdb1.APP01.EMPLOYEES.Value",
"field":"before"},{"type":"struct","fields":[{"type":"int32","optional":false,"field":"ID"},{"type":"string","optional":true,"field":"NAME"}],"optional":true,"name":"server01_orcl1_pdb1.APP01.EMPLOYEES.Value","field":"after"},
{"type":"struct","fields":[{"type":"string","optional":false,"field":"version"},{"type":"string","optional":false,"field":"connector"},{"type":"string","optional":false,"field":"name"},{"type":"int64","optional":false,"field":"ts_ms"},
{"type":"string","optional":true,"name":"io.debezium.data.Enum","version":1,"parameters":{"allowed":"true,first,first_in_data_collection,last_in_data_collection,last,false,incremental"},"default":"false","field":"snapshot"},
{"type":"string","optional":false,"field":"db"},{"type":"string","optional":true,"field":"sequence"},{"type":"int64","optional":true,"field":"ts_us"},{"type":"int64","optional":true,"field":"ts_ns"},{"type":"string","optional":false,
"field":"schema"},{"type":"string","optional":false,"field":"table"},{"type":"string","optional":true,"field":"txId"},{"type":"string","optional":true,"field":"scn"},{"type":"string","optional":true,"field":"commit_scn"},
{"type":"string","optional":true,"field":"lcr_position"},{"type":"string","optional":true,"field":"rs_id"},{"type":"int64","optional":true,"field":"ssn"},{"type":"int32","optional":true,"field":"redo_thread"},{"type":"string",
"optional":true,"field":"user_name"},{"type":"string","optional":true,"field":"redo_sql"},{"type":"string","optional":true,"field":"row_id"},{"type":"int64","optional":true,"field":"commit_ts_ms"},{"type":"string","optional":true,
"field":"start_scn"},{"type":"int64","optional":true,"field":"start_ts_ms"}],"optional":false,"name":"io.debezium.connector.oracle.Source","version":1,"field":"source"},{"type":"struct","fields":[{"type":"string","optional":false,
"field":"id"},{"type":"int64","optional":false,"field":"total_order"},{"type":"int64","optional":false,"field":"data_collection_order"}],"optional":true,"name":"event.block","version":1,"field":"transaction"},{"type":"string",
"optional":false,"field":"op"},{"type":"int64","optional":true,"field":"ts_ms"},{"type":"int64","optional":true,"field":"ts_us"},{"type":"int64","optional":true,"field":"ts_ns"}],"optional":false,
"name":"server01_orcl1_pdb1.APP01.EMPLOYEES.Envelope","version":2},"payload":{"before":null,"after":{"ID":1,"NAME":"Yannick Jaquier"},"source":{"version":"3.1.3.Final","connector":"oracle","name":"server01_orcl1_pdb1",
"ts_ms":1752067845000,"snapshot":"false","db":"PDB1","sequence":null,"ts_us":1752067845000000,"ts_ns":1752067845000000000,"schema":"APP01","table":"EMPLOYEES","txId":"0900010093060000","scn":"141826617","commit_scn":"141826629",
"lcr_position":null,"rs_id":"0x0007ad.000052dc.009c","ssn":0,"redo_thread":1,"user_name":"APP01","redo_sql":null,"row_id":"AAAWIAAAoAAAACPAAA","commit_ts_ms":1752067846000,"start_scn":"141826617","start_ts_ms":1752067845000},
"transaction":null,"op":"c","ts_ms":1752067851379,"ts_us":1752067851379453,"ts_ns":1752067851379453243}}
Debezium connector for JDBC configuration
I create my applicative account in MariaDB with a database and the needed privileges:
MariaDB [(none)]> create user 'app01'@'%' identified by 'secure_password';
Query OK, 0 rows affected (0.009 sec)

MariaDB [(none)]> create database test character set utf8mb4 collate utf8mb4_general_ci comment 'My test database';
Query OK, 1 row affected (0.002 sec)

MariaDB [(none)]> grant all on test.* to 'app01'@'%';
Query OK, 0 rows affected (0.001 sec)

MariaDB [(none)]> flush privileges;
Query OK, 0 rows affected (0.001 sec)
The Oracle tables will be automatically created in MariaDB…
The MariaDB sink connector configuration I have drafted is:
{
  "name": "mariadb-jdbc-sink-connector",
  "config": {
    "connector.class": "io.debezium.connector.jdbc.JdbcSinkConnector",
    "tasks.max": "1",
    "connection.url": "jdbc:mariadb://server01.domain.com:3316/test",
    "connection.username": "app01",
    "connection.password": "secure_password",
    "insert.mode": "upsert",
    "delete.enabled": "true",
    "primary.key.mode": "record_key",
    "schema.evolution": "basic",
    "use.time.zone": "UTC",
    "topics.regex": "server01_orcl1_pdb1.APP01.(.*)",
    "collection.name.format": "${source.table}"
  }
}
Remarks:
- By default collection.name.format is equal to ${topic} means that destination table will be called server01_orcl1_pdb1.APP01.EMPLOYEES: not fun ? I agree…
- You could also use “topics”: “server01_orcl1_pdb1.APP01.EMPLOYEES” and specify manually the list of topics but this is not schema oriented. The sink connector must be restarted each time you add a table while the source connector update dynamically the list of topics.
UI for Apache Kafka
To ease my life and avoid typing again and again shell commands during all the testing I have done I have decided to use a Kafka UI. Amongst all products two have kept my attention:
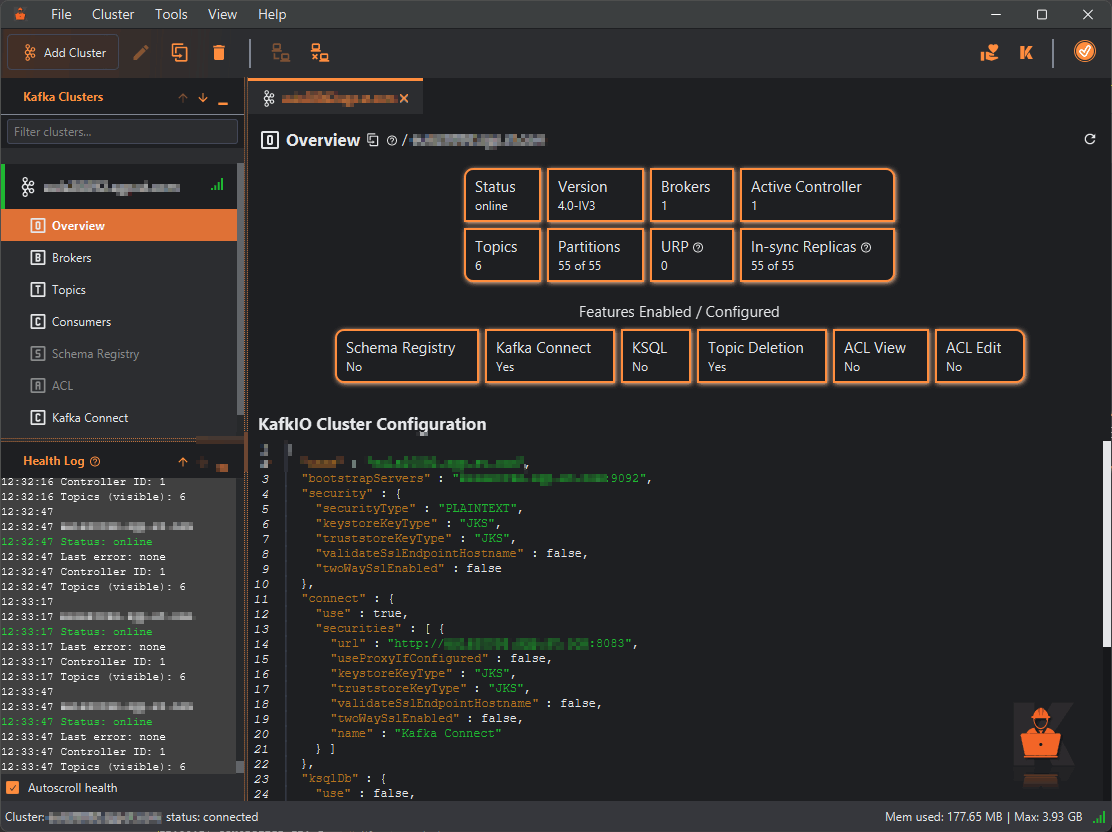
Kafkio is nice but you need to install on your client (there is a Windows portable no-install version):
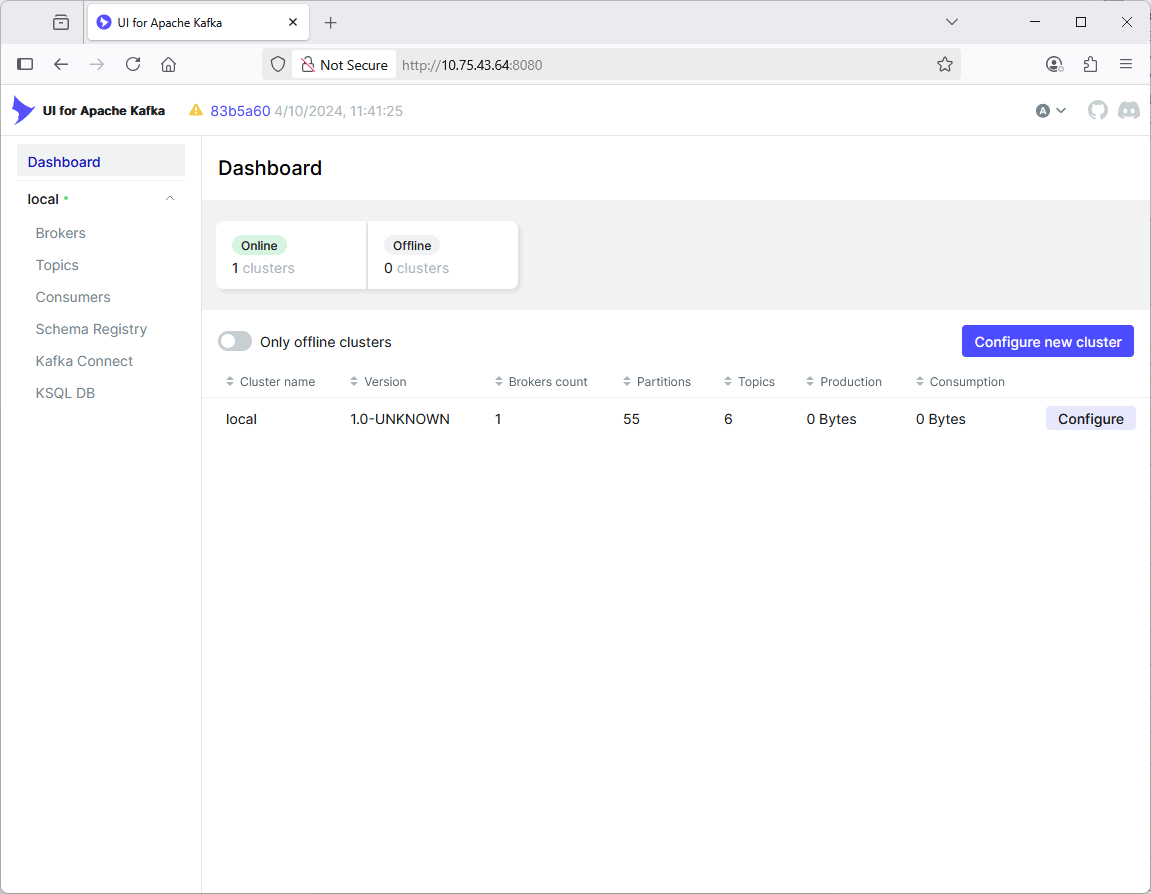
I have more appreciated the web approach of Kafka UI where the process is running on a server and you access to it with a browser.
To install it I have over-simplified the template application-local.yml configuration file to start:
logging:
  level:
    root: INFO
    com.provectus: DEBUG
    #org.springframework.http.codec.json.Jackson2JsonEncoder: DEBUG
    #org.springframework.http.codec.json.Jackson2JsonDecoder: DEBUG
    reactor.netty.http.server.AccessLog: INFO
    org.springframework.security: DEBUG

#server:
#  port: 8080 #- Port in which kafka-ui will run.

spring:
  jmx:
    enabled: true

kafka:
  clusters:
    - name: local
      bootstrapServers: localhost:9092
      schemaRegistry: http://localhost:8085
      ksqldbServer: http://localhost:8088
      kafkaConnect:
        - name: first
          address: http://localhost:8083
      metrics:
        port: 9997
        type: JMX

dynamic.config.enabled: true
Start UI for Apache Kafka with:
nohup java -Dspring.config.additional-location=/home/kafka/application-local.yml --add-opens java.rmi/javax.rmi.ssl=ALL-UNNAMED -jar /home/kafka/kafka-ui-api-v0.7.2.jar > ~/kafka-ui-api.log 2>&1 &
Then go to localhost:8080 or ip_address:8080:
If you don’t use a graphical interface then for topics use kafka-topics.sh (examples above) and for Kafka Connect you have to use curl (but I have not used it). Example commands (8083 is default Kafka Connect port):
# To delete a connector use
[kafka@server01 ~]$ curl -i -X DELETE localhost:8083/connectors/mariadb-jdbc-sink-connector
HTTP/1.1 204 No Content
Server: Jetty(12.0.15)
Date: Wed, 09 Jul 2025 14:19:15 GMT

# To create a new connector use
[kafka@server01 ~]$ cat mariadb-jdbc-sink-connector.json
{
  "name": "mariadb-jdbc-sink-connector",
  "config": {
    "connector.class": "io.debezium.connector.jdbc.JdbcSinkConnector",
    "tasks.max": "1",
    "connection.url": "jdbc:mariadb://server01.domain.com:3316/test",
    "connection.username": "app01",
    "connection.password": "secure_password",
    "insert.mode": "upsert",
    "delete.enabled": "true",
    "primary.key.mode": "record_key",
    "schema.evolution": "basic",
    "use.time.zone": "UTC",
    "topics.regex": "server01_orcl1_pdb1.APP01.(.*)",
    "collection.name.format": "${source.table}"
  }
}
[kafka@server01 ~]$ curl -i -X POST -H "Accept:application/json" -H "Content-Type:application/json" localhost:8083/connectors/ --data "@mariadb-jdbc-sink-connector.json"
HTTP/1.1 201 Created
Server: Jetty(12.0.15)
Date: Wed, 09 Jul 2025 14:28:44 GMT
Location: http://localhost:8083/connectors/mariadb-jdbc-sink-connector
Content-Type: application/json
Content-Length: 599

{"name":"mariadb-jdbc-sink-connector","config":{"connector.class":"io.debezium.connector.jdbc.JdbcSinkConnector","tasks.max":"1","connection.url":"jdbc:mariadb://server01.domain.com:3316/test",
"connection.username":"app01","connection.password":"secure_password","insert.mode":"upsert","delete.enabled":"true","primary.key.mode":"record_key","schema.evolution":"basic","use.time.zone":"UTC",
"topics.regex":"server01_orcl1_pdb1.APP01.(.*)","collection.name.format":"${source.table}","name":"mariadb-jdbc-sink-connector"},"tasks":[{"connector":"mariadb-jdbc-sink-connector","task":0}],"type":"sink"}
Issues encountered
Failed to process record: Failed to resolve column type for schema: STRUCT
Complete error message is:
[2025-07-08 14:47:19,358] ERROR [mariadb-jdbc-sink-connector|task-0] Failed to process record: Failed to resolve column type for schema: STRUCT (io.debezium.connector.oracle.Source) (io.debezium.connector.jdbc.JdbcSinkConnectorTask:137)
org.apache.kafka.connect.errors.ConnectException: Failed to resolve column type for schema: STRUCT (io.debezium.connector.oracle.Source)
        at io.debezium.connector.jdbc.dialect.GeneralDatabaseDialect.getSchemaType(GeneralDatabaseDialect.java:490) ~[debezium-connector-jdbc-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.jdbc.JdbcSinkRecord$FieldDescriptor.init(JdbcSinkRecord.java:59) ~[debezium-connector-jdbc-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.jdbc.JdbcKafkaSinkRecord.applyNonKeyField(JdbcKafkaSinkRecord.java:231) ~[debezium-connector-jdbc-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.jdbc.JdbcKafkaSinkRecord.applyNonKeyFields(JdbcKafkaSinkRecord.java:224) ~[debezium-connector-jdbc-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.jdbc.JdbcKafkaSinkRecord.readSinkRecordNonKeyData(JdbcKafkaSinkRecord.java:107) ~[debezium-connector-jdbc-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.jdbc.JdbcKafkaSinkRecord.init(JdbcKafkaSinkRecord.java:63) ~[debezium-connector-jdbc-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.jdbc.JdbcChangeEventSink.execute(JdbcChangeEventSink.java:77) ~[debezium-connector-jdbc-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.jdbc.JdbcSinkConnectorTask.put(JdbcSinkConnectorTask.java:128) ~[debezium-connector-jdbc-3.1.3.Final.jar:3.1.3.Final]
        at org.apache.kafka.connect.runtime.WorkerSinkTask.deliverMessages(WorkerSinkTask.java:606) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.WorkerSinkTask.poll(WorkerSinkTask.java:345) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.WorkerSinkTask.iteration(WorkerSinkTask.java:247) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.WorkerSinkTask.execute(WorkerSinkTask.java:216) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.WorkerTask.doRun(WorkerTask.java:226) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.WorkerTask.run(WorkerTask.java:281) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.isolation.Plugins.lambda$withClassLoader$1(Plugins.java:238) ~[connect-runtime-4.0.0.jar:?]
        at java.base/java.util.concurrent.Executors$RunnableAdapter.call(Executors.java:539) [?:?]
        at java.base/java.util.concurrent.FutureTask.run(FutureTask.java:264) [?:?]
        at java.base/java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1136) [?:?]
        at java.base/java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:635) [?:?]
        at java.base/java.lang.Thread.run(Thread.java:840) [?:?]
Then saw in Debezium documentation:
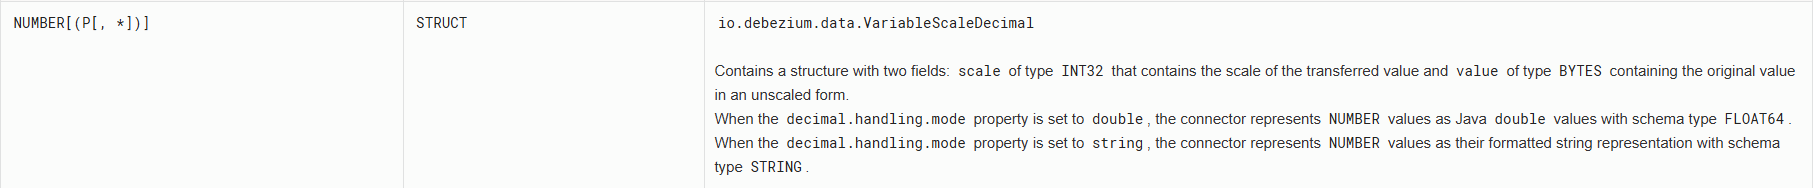
My initial Oracle table creation was simply using NUMBER datatype. Oracle has INTEGER, INT and SMALLINT datatype to support ANSI types but they are equivalent to NUMBER(38), so re-created the table by replacing NUMBER by NUMBER(38). It works but the MariaDB table has a decimal datatype. So finally recreated the table in Oracle with ANSI type INT:
create table app01.employees (
  id int not null,
  name varchar2(50),
  constraint employees_pk primary key (id) enable
);
But it gave a DECIMAL MariaDB datatype… What I would like to see in MariaDB is an INT so you have to play with NUMBER(s). Number(4) = SMALLINT, NUMBER(6) = INT
io.debezium.DebeziumException: The db history topic is missing. You may attempt to recover it by reconfiguring the connector to recovery.
Complete error message is:
[2025-07-08 15:47:55,280] ERROR [server01_orcl1_pdb1_app01|task-0] WorkerSourceTask{id=server01_orcl1_pdb1_app01-0} Task threw an uncaught and unrecoverable exception.
Task is being killed and will not recover until manually restarted (org.apache.kafka.connect.runtime.WorkerTask:234)
io.debezium.DebeziumException: The db history topic is missing. You may attempt to recover it by reconfiguring the connector to recovery.
        at io.debezium.connector.common.BaseSourceTask.validateAndLoadSchemaHistory(BaseSourceTask.java:125) ~[debezium-core-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.oracle.OracleConnectorTask.start(OracleConnectorTask.java:109) ~[debezium-connector-oracle-3.1.3.Final.jar:3.1.3.Final]
        at io.debezium.connector.common.BaseSourceTask.start(BaseSourceTask.java:256) ~[debezium-core-3.1.3.Final.jar:3.1.3.Final]
        at org.apache.kafka.connect.runtime.AbstractWorkerSourceTask.initializeAndStart(AbstractWorkerSourceTask.java:279) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.WorkerTask.doStart(WorkerTask.java:176) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.WorkerTask.doRun(WorkerTask.java:225) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.WorkerTask.run(WorkerTask.java:281) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.AbstractWorkerSourceTask.run(AbstractWorkerSourceTask.java:79) ~[connect-runtime-4.0.0.jar:?]
        at org.apache.kafka.connect.runtime.isolation.Plugins.lambda$withClassLoader$1(Plugins.java:238) ~[connect-runtime-4.0.0.jar:?]
        at java.base/java.util.concurrent.Executors$RunnableAdapter.call(Executors.java:539) [?:?]
        at java.base/java.util.concurrent.FutureTask.run(FutureTask.java:264) [?:?]
        at java.base/java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1136) [?:?]
        at java.base/java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:635) [?:?]
        at java.base/java.lang.Thread.run(Thread.java:840) [?:?]
Change this in Oracle source connector:
"snapshot.mode": "recovery"
References
About Post Author